
Megmértük, mit tud a mesterséges intelligencia egy valós IT-projekt dokumentációvagyonán
Kétrészes cikksorozatunk első része: problémafelvetés és módszertan
Aki dolgozott már nagyobb informatikai projekten, ismeri a helyzetet: az új kolléga keres egy specifikus információt egy többéves időszakot felölelő IT-projekt anyagban, ahol a követelmény benne van az igényspecifikációban, a hozzá tartozó tesztesetek egy jegyzőkönyvben, a kettő keletkezése közben eltelt egy év és jó esetben, több megfelelően verziózott változat került fel különböző mappastruktúrákba. Amikor az auditor egy ellenőrzés során megkérdezi, hogy a sikertelen bejelentkezések naplózását végül ki tesztelte le, valakinek le kell ülnie, és végig kell lapoznia sok száz vagy ezer oldalt, sok esetben nem is általa írt és ismert anyagokból. Erre a munkára ma már kézenfekvő volna nyelvi modellt használni, hiszen ezek a rendszerek pillanatok alatt válaszolnak, és a válaszuk rendszerint meggyőzőnek hangzik. Csakhogy a meggyőző válasz és a helyes válasz nem ugyanaz.
Mivel az AI fejlődése kapcsán gyakorlatilag hónapról hónapra új elvárások és ígéretek hallhatók, és ezzel párhuzamosan egyre nagyobb mértékű kontroll nélküli használat figyelhető meg a nagy nyelvi modellek kapcsán, úgy döntöttünk, megmérjük, mit tudnak ezek a rendszerek olyan dokumentumokon, amilyenekkel a mindennapokban dolgozunk. Egy lezárult, többéves energetikai fejlesztési projekt teljes magyar nyelvű dokumentumvagyonát vettük elő, összesen negyvenhét dokumentumot, melyek sok ezer oldal technikai, módszertani dokumentumot, megalapozó tanulmányt, követelményspecifikációkat, tesztjegyzőkönyveket, elfogadási kritériumokat tartalmaznak, és ezek alapján hatszázhetven kérdést tettünk fel róluk öt különböző nagy nyelvi modellnek. Jelen cikkünkben azt tűztük ki célul, hogy megmutassuk, először is miért éppen a saját szerveren futtatható megoldások érdekeltek minket, mire szerettük volna a modelleket használni, és hogyan raktuk össze a mérést úgy, hogy az eredménynek hinni lehessen. Hogy a tesztünk végén milyen eredmények jöttek ki, arról sorozatunk második cikkében lesz szó mélységében.
Mit mutatnak a meglévő mérések, és mire nem adnak választ
Jelen tanulmányunk témáját sok kutatás próbálta már körüljárni, csakhogy azok sok esetben nem a számunkra érdekes problémát ragadják meg. A legelterjedtebb nemzetközi mércék angol nyelvű Wikipédia-szócikkekre épülnek, ilyen a HotpotQA és a MuSiQue [1, 2], mások hírcikkekből (MultiHop-RAG [3]) vagy amerikai tőzsdei cégek pénzügyi jelentéseiből (FinanceBench [4]) dolgoznak. A tartalomjegyzék mentén kereső megoldások hatékonysága körüli vita jelenleg is zajlik, és az eredmények ellentmondanak egymásnak: a PageIndex fejlesztői 98,7 százalékos pontosságot közöltek a PageIndexre épülő rendszerükről [5], a PwC kutatói viszont egy hasonló, amerikai tőzsdei bejelentésekből épített saját mércén azt találták, hogy az esetek 68 százalékában a vektoros, a modell által irányított keresés adott jobb választ [6]. A hazai kutatóközpontok, köztük a Nyelvtudományi Kutatóközpont, az ELTE és a szegedi mesterségesintelligencia-kutatócsoport, főként azt vizsgálják, mennyire tudnak a modellek magyarul, illetve hogyan érdemes a szöveget a kereséshez előkészíteni. Olyan vizsgálattal viszont nem találkoztunk, amely egy valós, informatikai és energetikai szakterületet egyaránt érintő projekt teljes életciklusának eredménytermékeit egyben vizsgálná: olyan dokumentumvagyont, amelynek darabjai egymásból következnek és/vagy egymásra épülnek, és ahol a jó válaszhoz ezeket az összetett szakmai anyagokból releváns tartalmakat egyszerre kell megtalálni, értelmezni és összevetni. Ezért a kutatást az adatelőkészítéstől a mérésen át a kiértékelésig magunk végeztük el, több modellel és többféle kereséssel.
Miért a saját környezetben futó megoldásokat vizsgáltuk
Egy felhős szolgáltatásnál a kérdés, illetve üzleti információk és vele a dokumentum részlete elhagyja a saját környezetet, a költség a használattal együtt jelentősen nőhet, a modellt pedig a szolgáltató bármikor lecserélheti, és ilyenkor ugyanarra a kérdésre másnap már más válasz érkezhet: a régi modellhez hangolt utasítások másképp működnek, a korábban mért pontosság nem érvényes többé, a reprodukálhatóság sérülhet. Ha a rendszer a saját szerverünkön fut, a dokumentum a saját biztonságos üzleti környezetben marad, minden lépés naplózható, a költség egyszeri beruházás, a modell pedig addig ugyanaz marad, amíg mi másként nem döntünk: új változatra csak azután váltunk, hogy a saját kérdéssorunkon újra lemértük, a régi pedig a korábbi válaszok visszaellenőrzéséhez megőrizhető. Szó szerint azonos választ a saját szerveren futó megoldás sem garantál, mert a nyelvi modellek működésében van véletlenszerűség: a saját mérésünkben ugyanaz a beállítás kétszer lefuttatva összesítve szinte azonos eredményt adott, az egyes kérdéseknél viszont előfordult eltérő válasz. Amit a saját üzemeltetés ad, az a visszakövethetőség: tudjuk, melyik modellváltozat, milyen beállítással és mely szövegrészek alapján válaszolt, és ugyanez a környezet később is összerakható. Ennek természetesen ára van: szervergépet kell venni, azt üzemeltetni kell, és a ma elérhető legerősebb modellek közül több egyáltalán nem telepíthető rájuk, vagy csak nagyon komoly egyszeri CAPEX-ráfordítás mellett. Saját környezetbe ugyanis csak úgynevezett nyílt súlyú modell telepíthető: olyan, amelynek betanított paramétereit, vagyis a súlyait a fejlesztője közzétette, így a modell letölthető, és a szervezet a saját gépén futtathatja. A zárt modellekhez, amilyen a legismertebb frontier modellek többsége, csak a fejlesztő szolgáltatásán keresztül lehet hozzáférni.
Amit a szabályozás hozzátesz
Jelenleg a jogszabályok egyike sem írja elő explicit módon, hogy mesterséges intelligenciát csak saját gépen/környezetben szabad futtatni, a szabályozás azonban egyre nagyobb bizonyítási és ellenőrzési felelősséget helyez az érzékeny adatokkal dolgozó szervezetekre, a saját üzemeltetés pedig lehetővé teszi, hogy ezt az ellenőrzést közvetlenül maguk gyakorolják. Magyarországon a kiberbiztonsági törvény (2024. évi LXIX. törvény, 9. §) és a végrehajtási rendelete (418/2024. (XII. 23.) Korm. rendelet) adatosztályozáshoz köti, hogy az érintett szervezetek meghatározott köre igénybe vehet-e nem privát felhőszolgáltatást, illetve kezelhet-e adatot külföldön. A nem privát felhő az, ahol a szolgáltató ugyanazon az infrastruktúrán sok ügyfelet szolgál ki; a kiberbiztonsági hatóság példái erre a Microsoft 365, az AWS, az Azure és a Google Cloud általánosan elérhető szolgáltatásai, bár ugyanezek a szolgáltatók elkülönített, privát megoldásokat is kínálnak. A privát felhőben ezzel szemben minden hardver és szoftver a szervezet számára rendelkezésre áll, és csak a szervezeten belülről érhető el [7, 8]. A rendelet négy osztályt különböztet meg (F1–F4), a besorolás pedig azon múlik, mekkora kárt okozna, ha az adat illetéktelen kézbe kerülne, megsérülne vagy elérhetetlenné válna. A rendelet indokolása a jelentős kárral járó szint példájaként éppen a projektdokumentumokat, a szervezeti szabályzatokat és az ajánlatokat említi, a kritikus szintnél pedig az üzleti titkot és a különleges vagy tömeges személyes adatokat. A legmagasabb (F4) osztályba sorolt adatok főszabály szerint csak Magyarország területén kezelhetők, felhőben pedig kizárólag harmadik fél által tanúsított privát vagy kormányzati felhőben. Aki nem privát felhőt használna vagy külföldön kezelne adatot, annak a döntés előtt kilépési tervet kell készítenie arról, hogyan állna vissza helyi környezetre vagy privát felhőre; az érintettek egy részének ezen felül költség-haszon elemzéssel kell igazolnia, hogy a felhő megalapozottan előnyökkel jár (3. §). A pénzügyi szektorban a digitális működési rezilienciáról szóló uniós rendelet (DORA, (EU) 2022/2554) 2025. január 17. óta hasonló fegyelmet vár el: a külső informatikai szolgáltatóktól való függést kezelni kell, a kritikus vagy fontos funkciókat támogató szolgáltatásokhoz pedig dokumentált és tesztelt kilépési stratégia szükséges.
Az uniós jogalkotás ugyanebbe az irányba halad, amit a már elfogadott és a tárgyalás alatt álló jogszabályok egyaránt mutatnak. A mesterséges intelligenciáról szóló rendelet ((EU) 2024/1689) a magas kockázatú rendszereknél naplózást, emberi felügyeletet és részletes dokumentációt követel meg, a fejlesztőre és az alkalmazó szervezetre eltérő felelősséget róva; ezeknek a kötelezettségeknek az alkalmazását a 2026 júliusában hatályba lépett módosító rendelet ((EU) 2026/1744) a III. melléklet szerinti rendszereknél 2027. december 2-ára, az I. melléklethez kapcsolódóknál 2028. augusztus 2-ára halasztotta, vagyis van idő felkészülni, de a követelmény jelen van. A rendelet nem mondja meg, hol fusson a rendszer, azt viszont igen, hogy a működését naplózni, dokumentálni és felügyelni kell, bárhol is fut. Az Európai Bizottság pedig 2026. június 3-án, a technológiai szuverenitási csomag részeként benyújtotta a felhő- és MI-fejlesztési rendelet javaslatát (Cloud and AI Development Act, COM(2026) 502), amely a közszféra felhőhasználatában négy szuverenitási szintet vezetne be, a tagállamoknak pedig szuverenitási kockázatértékelést írna elő; a tervezet szerint ez később a kiberbiztonsági szabályozás alá tartozó ágazatok magánszereplőire is kiterjeszthető [9]. A javaslat még nem hatályos jogszabály, de jelzi, hogy a felhőszolgáltatások feletti ellenőrzés és az adatszuverenitás önálló szabályozási kérdéssé válik. Aki tehát érzékeny adatokkal és dokumentumokkal dolgozik, annak egyre többször kell majd megmutatnia, hol van az adata, ki fér hozzá, és hogyan tudna szolgáltatót váltani. Saját üzemeltetés mellett ezekre a kérdésekre könnyebb felelni. Ha például egy belső auditor vagy a hatóság megkérdezi, hol tárolódnak a rendszerbe feltöltött szerződések, a rájuk feltett kérdések és a keresési indexek, saját üzemeltetésnél a válasz egyetlen mondat: a szervezet saját géptermében álló szerveren, amelyhez a saját jogosultsági rendünk szerint kijelölt munkatársak férnek hozzá, minden lekérdezés a saját naplónkban szerepel, a megőrzési időkről és a naplózás szabályairól pedig a szervezet maga dönt. Felhős szolgáltatásnál ugyanehhez ellenőrizni kell az adatfeldolgozás helyét, az igénybe vett alfeldolgozókat, a hozzáférés és az adattovábbítás szabályait, valamint az adatok törlésének és visszanyerésének feltételeit, a szolgáltatóváltás pedig adatköltöztetéssel és a rendszer újbóli bemérésével jár. Ezek a kockázatok megfelelő felhőarchitektúrával és szerződéses garanciákkal mérsékelhetők, de a szervezet ebben a szolgáltató együttműködésére szorul.
Amit a piac mutat
A piaci adatok ugyanezt az igényt mutatják, de árnyaltabban, mint ahogy gyakran hallani. A Gartner előrejelzése szerint az európai szervezetek szuverén felhőre fordított kiadása 2025 és 2027 között több mint háromszorosára nő, 6,9 milliárdról 23,1 milliárd dollárra [10]. A német Bitkom reprezentatív felmérésében a cégek 85 százaléka mondta, hogy az ország túlságosan függ az amerikai felhőszolgáltatóktól, a felhőt használó cégek 64 százaléka pedig úgy érzi, hogy az amerikai kormány politikája miatt át kell gondolnia a felhőstratégiáját [11]. Egy 1 800 informatikai vezető megkérdezésével, gyártói megrendelésre készült felmérés szerint egy év alatt 56-ról 41 százalékra csökkent azoknak a vállalatoknak az aránya, amelyek az éles MI-rendszereiket elsősorban nyilvános felhőben futtatják [12]. Az IDC független felmérése ugyanakkor kiegyenlített megoszlást talált a privát és a nyilvános környezet között [13], és a Bitkom adatai szerint a felhőből igénybe vett MI-szolgáltatások használata is tovább nő. A szabályozás és a piac tehát nem egyetlen megoldás, hanem a nagyobb kontroll felé mozdul. Ennek egyik formája a szuverén felhő, a másik a saját környezet, amely ott a legkézenfekvőbb, ahol az adat a legérzékenyebb. Hogy ez egyáltalán választható, azt a nyílt súlyú modellek fejlődése teszi lehetővé: az Epoch AI mérése szerint a legjobbak átlagosan négy hónapos lemaradással követik a legerősebb zárt modelleket [14].
Milyen üzleti használati esetekre gondoltunk
Három helyzetre kerestünk megoldást, mindhárom a napi munkánkból ismerős.
Az első, amikor valaki egyetlen dokumentumból vár pontos, visszakereshető választ. Az auditor, a minőségbiztosító vagy az üzleti elemző nem éri be annyival, hogy a rendszer szerint a szerződés előírja a napi mentést, látni akarja, melyik pontban és milyen feltételek mellett. Itt a hibás válasznál is rosszabb lehet a majdnem jó válasz, mert utóbbi kevésbé tűnik fel. A nyilvánvalóan hibás választ az elemző észreveheti és elveti. Ha viszont a rendszer helyesen idézi a mentésre vonatkozó előírást, csak éppen a szerződés egy korábbi, azóta módosított változatából, akkor a válasz hihető, a forrásmegjelölés is rendben lévőnek látszik.
A második, amikor több dokumentumot kell egymás mellé tenni. Teljesült-e, amit a követelmény előír, van-e rá teszt, és nem mond-e mást a tesztelési terv, mint a tesztjegyzőkönyv? A minőségbiztosítás és az átvétel jórészt ilyen kérdésekből áll. Ma ezt emberek végzik, sok manuális munkával és kézi ellenőrzéssel. Véleményünk szerint ez a terület lehet üzletileg az egyik legfontosabb kiaknázatlan lehetőség a mesterséges intelligencia felelős használatához.
A harmadik egy adott dokumentumvagyon tudásanyagának célzott keresése: az új kolléga vagy az ügyfélszolgálati munkatárs megkérdezi, melyik szabályzat szól a távoli hozzáférésről, és nem akar két percet várni a válaszra. A kérdések itt egyszerűbbek, a gyorsaság viszont követelmény.
Milyen kérdéseket tettünk fel
Az első két helyzetet kérdéstípusokra bontottuk, mert az, hogy a rendszer „dokumentumból válaszol”, túl tág ahhoz, hogy mérni lehessen. A kérdéstípusokat nem találomra választottuk. Abból indultunk ki, hol szoktak a kisebb modellek elbukni: megállnak az első dokumentumnál, amikor egy másodikban kellene folytatni a keresést; lefedettséget állítanak ott, ahol nincs, mert a „van rá teszt” nyelvileg valószínűbb válasz, mint a „nincs”, és rábólintanak egy hihetően hangzó állításra akkor is, ha a forrás mást mond. A táblázat mind a tizenöt típust felsorolja egy-egy példával.
| Kérdéstípus | Mit kell tudnia a rendszernek | Példa |
|---|---|---|
| Egy dokumentumon belül (351 kérdés) | ||
| Konkrét tény megkeresése | Megtalálni egy adatot ott, ahol le van írva | Hány napig tart a próbaüzem? |
| Válasz összeállítása több szakaszból | Egymástól távoli részekből összerakni a választ | Hogyan kapcsolódik az adatfogadó modul az adatfeldolgozóhoz, és milyen hibakezelés vonatkozik rá? |
| Belső hivatkozás követése | Eljutni oda, ahová a szöveg hivatkozik | A 3.2 pont a 7. mellékletre utal. Mit ír elő ott a mentésről? |
| A pontos hely megadása | Megmondani, hol szerepel valami | Melyik fejezet írja le a jogosultsági szinteket? |
| Hiányzó tartalom kimutatása | Észrevenni, hogy valami nincs benne a dokumentumvagyonban | Szerepel-e a telepítési leírásban a visszaállítás menete? (Az elvárt válasz nem puszta „nem”: azt is meg kell indokolnia, miről szól ehelyett a dokumentum.) |
| Eldönthetetlen kérdés felismerése | Kimondani, hogy a dokumentumok erre nem adnak választ | Mekkora a rendszer éves üzemeltetési költsége? |
| Két dokumentum együtt, explicit kapcsolattal: az összetartozást maguk a dokumentumok jelzik | ||
| Előírás és a bizonyíték összepárosítása | Az egyik dokumentum előír, a másik igazol | A szerződés előírja a napi mentést. Igazolja-e a tesztjegyzőkönyv, hogy megvalósult? |
| Tartalom hiányának ellenőrzése | Kimondani, hogy az igazolás hiányzik | Tartalmaz-e a tesztjegyzőkönyv bármit a folyamatos ügyeletről? |
| Ellentmondás vizsgálata | Két állítást összevetni | Az egyik terv 300 ezer végpontot ír, a másik 500 ezret. Ellentmondanak-e egymásnak? |
| Hivatkozás követése a másik dokumentumba | Átmenni a hivatkozott dokumentumba, és ott megtalálni a választ | A specifikáció az architektúraterv 4.2 fejezetére utal. Mit rögzít az a fejezet? |
| Átvett szövegrész azonosítása | Felismerni, hogy a szó szerinti ismétlés még nem bizonyíték | A jegyzőkönyv szó szerint megismétli a követelményt, eredményt viszont nem közöl. Igazolja-e a teljesülést? |
| Verziók összevetése | Megmondani, mi változott | Miben tér el a harmadik fázis igényspecifikációja a másodikétól? |
| Két dokumentum együtt, implicit kapcsolattal: tartalmi összefüggés, hivatkozás nélkül | ||
| Összetartozás közös kód alapján | Észrevenni, hogy ugyanaz az azonosító két helyen szerepel | Egy követelménykód megvan a specifikációban és a tesztben is, de egyik sem utal a másikra. |
| Összetartozás közös szakszó alapján | Ugyanarra a szakkifejezésre ráismerni, kód nélkül | Mindkét dokumentum az egyszeri bejelentkezésről ír. |
| Azonos tartalom eltérő szóhasználattal | Ugyanazt a gondolatot más szavak mögött megtalálni | Az egyik „sikertelen bejelentkezés naplózását” írja elő, a másik azt rögzíti: „hibás jelszó háromszor, naplóbejegyzés keletkezett”. |
A két dokumentumot érintő 319 kérdés két csoportra oszlik, és ez a megkülönböztetés a mérés egyik legfontosabb döntése volt. Az első hatnál (explicit kapcsolat) a dokumentumok maguk jelzik, hogy összetartoznak, például hivatkoznak egymásra. Az utolsó háromnál (implicit kapcsolat) semmi ilyen kapaszkodó nincs: a két dokumentum ugyanarról szól, illetve a tartalmuk együtt ad választ egy komplexebb kérdésre, de egyik sem hivatkozik a másikra. A valóságban ez egy elég gyakori eset, és jelentős mértékben befolyásolja a modellek teljesítményét, hogy az ilyen típusú feladatokon milyen teljesítményt képesek nyújtani.
A dokumentumok
A méréshez egy több fázisban megvalósult fejlesztési projekt teljes iratanyagát használtuk, negyvenhét dokumentumot, együtt nagyjából 4 700 oldalt. Van köztük igényspecifikáció, architektúra- és infrastruktúraterv, programozói kézikönyv, tesztelési terv, teszt- és próbaüzemi jegyzőkönyv, hibajegy-kimutatás, hiánypótlás és telepítési leírás. Ezek a dokumentumok egymásra épülnek: az egyik előír valamit, a másik megtervezi, a harmadik igazolja, hogy elkészült. Több közülük egymás után több verzióban is megjelent, így a rendszernek a jó dokumentumon belül a jó változatot is meg kell találnia. A projektet és a megrendelőt nem nevezzük meg, a táblázat példái pedig a valódi kérdések mintájára készült illusztrációk.
A modellek és a keresés
Öt nyelvi modellt próbáltunk ki. Négy közülük nyílt súlyú, tehát saját szerverre telepíthető. A legkisebb, egy 26 milliárd paraméteres modell, elfut egy 128 gigabájt memóriájú, asztali méretű szerveren; három nagyobbhoz, 180 és 320 milliárd paraméter között, már professzionális grafikus kártya kell; az ötödik pedig egy zárt, csak szolgáltatásként elérhető modell, amelyet viszonyítási alapnak vettünk fel (GPT-5.6 Luna). (A paraméterszám a modell méretét jelzi: minél több paraméterből áll egy modell, annál több memória kell a futtatásához. Ezért fér el a legkisebb egy asztali gépen, a nagyobbak pedig nem.) A kisebb modellt (Gemma 4, 26 milliárd paraméteres változat) saját szerveren, egy NVIDIA DGX Spark gépen, a nagyobb modelleket (Qwen3.8-Flash, DeepSeek V4-Flash, GLM-5.3-Flash) ebben a körben felhőből futtattuk, erre a második részben az eredményeknél is emlékeztetünk.
Mindegyik modellnek keresnie kell a dokumentumok között, mielőtt válaszol, és ezt háromféleképpen tehette. Az első kettő vektoros keresésre épül, vagyis a rendszer a kérdéshez jelentésében hasonló szövegrészeket keres ki. A legegyszerűbb változatban (RAG workflow) a rendszer egyszer keres, a nyolc legjobbnak ítélt szövegrészt átadja a modellnek, és abból kell válaszolnia. A második változatban, amelyet a szakma Agentic RAG-nak hív, maga a modell irányítja a keresést: ha nem találta meg, amit akart, átfogalmazza a kérdést, leszűkíti egy dokumentumra, vagy követ egy hivatkozást. A harmadik, a szerkezeti navigáció a PageIndex nevű megoldás elvét követi [5], és vektorok helyett a dokumentumok tartalomjegyzékére támaszkodik. Úgy dolgozik, ahogy egy ember tenné: megnézi a tartalomjegyzékeket, kiválasztja a szóba jöhető dokumentumokat és fejezeteket, és azokat olvassa el.
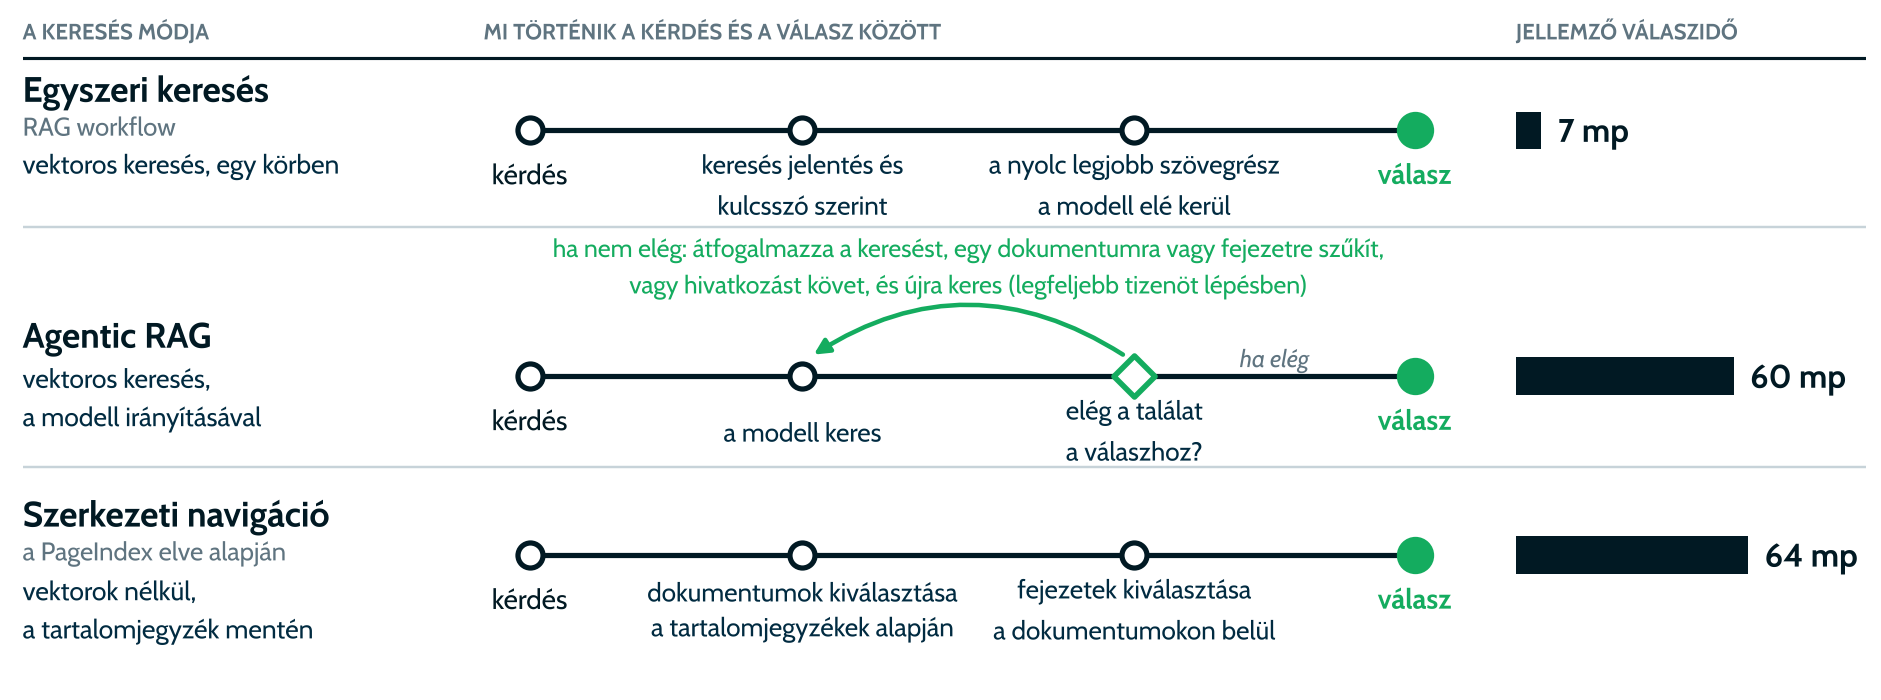
1. ábra. A keresés három módja, amelyet a mérésben összehasonlítottunk. Az Agentic RAG visszacsatolása azt jelenti, hogy ha a talált szövegrészek nem elegendők a válaszhoz, a modell átfogalmazza a keresést, egy dokumentumra vagy fejezetre szűkíti, illetve követ egy hivatkozást, és újra keres, legfeljebb tizenöt lépésben. A jobb oldali sáv azt mutatja, mennyi idő alatt érkezett meg jellemzően a válasz: a mért válaszok fele ennél gyorsabb volt, a fele lassabb.
Hogyan lett a kapcsolatokból kérdés
A kérdések összeállítása több munkát adott, mint maga a mérés. A nehezét azok a kérdések jelentették, amelyekhez két dokumentumot kell egyszerre ismerni, mert ehhez előbb meg kellett találnunk, mely dokumentumok tartoznak egyáltalán össze. Negyvenhét dokumentumnál ezt teljesen manuálisan nem életszerű végigcsinálni, úgyhogy programmal kerestettük meg a kapcsolatokat: hol hivatkozik az egyik dokumentum a másikra, hol szerepel mindkettőben ugyanaz a követelményazonosító, hol használják ugyanazt a ritka szakkifejezést. Többkörös szűkítés után végül 204 dokumentumpár maradt, amelyekről bizonyítani tudtuk, hogy összetartoznak.
Egy kérdés csak akkor használható mérésre, ha előre rögzítjük, mi rá a helyes válasz, és az ehhez tartozó bizonyítékot is megadjuk. A szakma ezt etalonnak (angolul ground truth) hívja. Nálunk minden kérdés etalonja négy részből áll:
- az elvárt válasz teljes mondatokban,
- azoknak a kulcstényeknek a listája, amelyeknek a jó válaszban szerepelniük kell,
- a válasz logikája, vagyis az indoklás arról, hogyan következik a válasz a forrásokból és
- a szó szerinti forrásidézetek, amelyek megmutatják, a dokumentum mely mondataira épül.
Egy hiányra vonatkozó kérdésnél például az elvárt válasz nem annyi, hogy „nem”, hanem az is, hogy a követelmény mit ír elő, és a másik dokumentum ehelyett miről szól. A választ alátámasztó mondatok rögzítése a nemzetközi mércéknél is szokás, például a HotpotQA esetében [1]; mi ezt azzal szigorítottuk, hogy az idézetnek betűre meg kell lennie a forrásban, és ezt program ellenőrzi. Így a pontozásnál nemcsak azt lehet megítélni, hogy a válasz végkövetkeztetése jó-e, hanem azt is, hogy a megfelelő okból jó-e.
A kérdéseket ezekre a párokra a kutatáskor elérhető legerősebb modellel írattuk meg, az elvárt válasszal és két szó szerinti idézettel együtt, egyet-egyet a két dokumentumból. A modellt API hívásokkal, kérdésenként külön, előzmények nélküli hívásban szólítottuk meg, így egyik kérdésnél sem támaszkodhatott arra, amit egy korábbinál látott vagy írt, és a kérdések között nem alakulhatott ki ismétlődő minta. Ugyanezt a szabályt követtük később a válaszadó modelleknél és a pontozásnál is: minden kérdés és minden válasz üres lappal indult. Ezután egy második, független menetben, a válasz ismerete nélkül megvizsgáltattuk, hogy a kérdés megválaszolható-e pusztán a megadott forrásokból, valóban kell-e hozzá mindkét dokumentum, és nem árulja-e el a kérdés szövege a megoldást. Kiszűrtük azokat a párokat is, amelyeknél a két idézet betűre azonos volt, mert az másolat, nem kapcsolat. Egy egyszerű program közben azt ellenőrizte, hogy az idézetek betűre megtalálhatók-e a forrásban. Ez utóbbi szűrte ki a legtöbb hibát, mert a modell hajlamos majdnem pontosan idézni. Ami megmaradt, azt üzleti elemző kollégáink, akik a dokumentumokat ismerik, soronként átnézték, három javítási körben, és eldöntötték, maradhat-e. Később azt is megvizsgáltuk, mennyire egységesen ítélnek ők maguk, de erről a pontozásnál lesz szó részleteiben. 319 kérdés jutott át a fenti összes szűrőn:
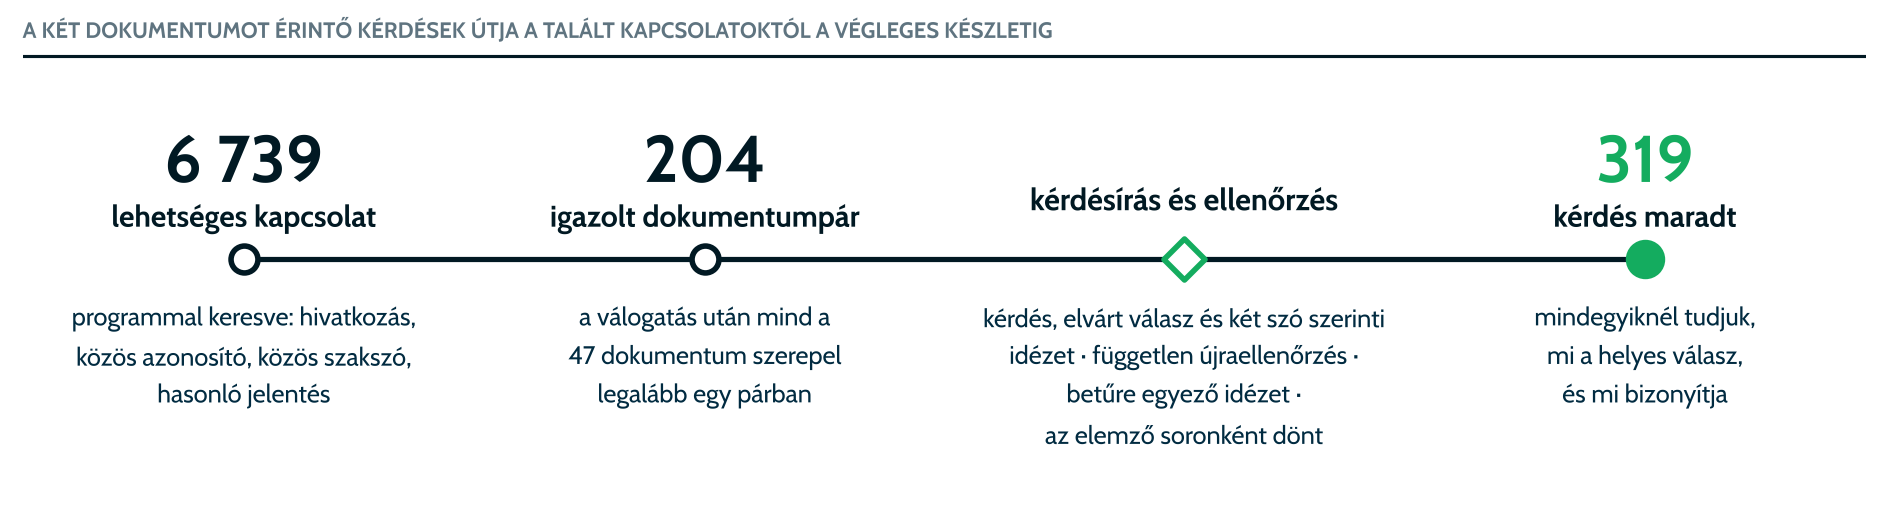
2. ábra. A két dokumentumot érintő kérdések útja a programmal talált kapcsolatoktól a végleges készletig. A két szó szerinti idézet miatt minden kérdésnél ellenőrizni lehet, hogy a rendszer valóban elérte-e mindkét dokumentumot, amelyre a válaszhoz szükség van.
Az eredmények kiértékelése: a pontozás
Több ezer választ kézzel nem célszerű végigkövetni, ezért a pontozást is nyelvi modellre bíztuk, de nem arra, amelyik a választ adta: ha egy modell a saját válaszát pontozza, hajlamos felmenteni magát. A bíró egy külső, erős modell volt, amely nem tudta, melyik modell és melyik keresési mód válaszát látja, minden választ külön, előzmények nélküli hívásban, kikapcsolt véletlenszerűséggel kapott meg, hogy a pontozás megismételhető legyen, előre rögzített szabály szerint dolgozott, és az ítéletét meg kellett indokolnia. Három fokozat közül választhatott: nulla pont jár a hibás vagy elmaradt válaszért, egy a részben helyesért, kettő a helyesért. A háromfokú skála bevett megoldás: a Meta CRAG nevű mércéje is háromkimenetű pontozást használ (helyes, hiányzó, hibás), és az önfelmentés elkerülésére két különböző bírómodellel dolgozik [15]; egy friss vizsgálat pedig három skálát összevetve a legkisebb granularitásút, a nullától ötig terjedőt találta az emberi ítélethez legközelebb állónak [16]. Mivel nálunk a hibás és az elmaradt válasz egyaránt nulla pont, a kitérést és a kitalált tartalmat külön mutatóként számoljuk.
Ha arra a kérdésre, hogy „igazolja-e a tesztelési terv a műszaki leírás döntéstámogatásra vonatkozó előírását?” az egyik modell azt mondta, hogy ez a dokumentumokból nem határozható meg, pedig a válasz megvolt bennük, nulla pontot adtunk. Ha a másik jól írta le a két dokumentum szerepét, de a tesztelési tervnek nem a kérdésben szereplő változatából dolgozott, és döntő adatok kimaradtak, egy pontot adtunk. Ha a harmadik mindkét dokumentumot megtalálta, a jó változatot olvasta, és a megfelelő forrással válaszolt, két pont járt.
Arról, hogy a bíró megbízható-e, kétféleképpen győződtünk meg. Ezerötszáz választ egy másik cég frontier modelljével is lepontoztattunk, úgy, hogy az nem tudta, melyik modell és melyik keresési mód adta a választ: a tételeket véletlen sorrendben, sorszámmal ellátva kapta meg. Négy üzleti elemző kollégánk pedig mintavétel után kézzel is lepontozta a válaszok egy részét ugyanazon szabály szerint, szintén a modell és a keresési mód ismerete nélkül. A mintába a vektoros keresésből és a PageIndex-elvű szerkezeti navigációból, rövid és hosszú válaszból, állásfoglalásból és kitérésből egyaránt válogattunk, így azt is láttuk, nem kedvez-e a bíró valamelyik keresési módnak.
Az eredmények vizsgálatakor azt néztük meg, hányszor fordul elő, hogy ugyanarra a válaszra az egyik értékelő nullát, a másik kettőt ad, ezt ugyanis jelentős eltérésként azonosítottuk. A gépi bíró és az emberek között ez a válaszok 4,8 százalékánál fordult elő, két ember között 4,9 százalékánál. A gép tehát nagyjából annyira tér el egy embertől, amennyire az emberek egymástól, és a vizsgált modell–keresés párosok sorrendjét mind a hat értékelő lényegében ugyanúgy látta. A részben helyes válaszok megítélésében viszont az emberek sem egységesek, ezért a pontszámok közti apró különbségekből nem vonunk le következtetést. Ez megfelel a szakirodalom ajánlásának is: a modelleket ugyanazokon a kérdéseken, páros különbségek alapján érdemes összevetni, és a mérési zajon belüli eltérés nem számít különbségnek [17]. A küszöb a saját ökölszabályunk: mivel ugyanaz a beállítás kétszer lefuttatva néhány századponttal eltért, egytizednél kisebb különbséget nem tekintünk rangsoroló mértékűnek.
A módszer nagy része bevett gyakorlat: az előre rögzített etalon, a gépi bíró emberi ellenőrzéssel, a háromfokú skála és a páros összevetés. A saját munkánk a kilenc kapcsolattípus explicit és implicit csoportja, a lefedettséget biztosító válogatás, a betűre ellenőrzött kettős idézet és a több szempont szerint kiegyensúlyozott emberi minta, valamint az, hogy a gépi bírót az emberek egymás közti egyezéséhez mérjük, ahogy egy friss nemzetközi munka is teszi [18].
A folytatásban arról lesz szó, mit mutattak meg a mérésünk eredményei: melyik modell melyik kereséssel mire jutott az egyes kérdéstípusokon, mi az, amit egy asztali méretű szerver is megbízhatóan megold, melyek a modellméretből fakadó korlátok, és mik azok a használati esetek, ahol a keresési architektúra és modellek jó megválasztásával az üzleti folyamatainkat sikerrel tudjuk a mesterséges intelligenciával támogatni.
Hivatkozások
[1] Yang, Z. és mtsai (2018): HotpotQA: A Dataset for Diverse, Explainable Multi-hop Question Answering. arXiv:1809.09600.
[2] Trivedi, H. és mtsai (2022): MuSiQue: Multihop Questions via Single-hop Question Composition. arXiv:2108.00573.
[3] Tang, Y., Yang, Y. (2024): MultiHop-RAG: Benchmarking Retrieval-Augmented Generation for Multi-Hop Queries. arXiv:2401.15391.
[4] Islam, P. és mtsai (2023): FinanceBench: A New Benchmark for Financial Question Answering. arXiv:2311.11944.
[5] VectifyAI: PageIndex. github.com/VectifyAI/PageIndex.
[6] Lumer, E. és mtsai (2026): Rethinking Retrieval: From Traditional Retrieval Augmented Generation to Agentic and Non-Vector Reasoning Systems in the Financial Domain for Large Language Models. ICAART 2026. arXiv:2511.18177.
[7] 2024. évi LXIX. törvény Magyarország kiberbiztonságáról (njt.jog.gov.hu/jogszabaly/2024-69-00-00); 418/2024. (XII. 23.) Korm. rendelet, 1. melléklet (adatosztályozás) és annak indokolása (njt.jog.gov.hu/jogszabaly/2024-418-20-22).
[8] Nemzeti Kiberbiztonsági Intézet: Felhő; Kérdések és válaszok a biztonsági osztályba sorolásról. nki.gov.hu/hatosag/tartalom/felho.
[9] Európai Bizottság: Proposal for a Regulation establishing a framework of measures for strengthening Europe’s cloud and AI ecosystem (Cloud and AI Development Act), COM(2026) 502 final, 2026. június 3. A szövegben említett további uniós rendeletek: (EU) 2024/1689, (EU) 2026/1744, (EU) 2022/2554.
[10] Gartner (2026. február 9.): Gartner Says Worldwide Sovereign Cloud IaaS Spending Will Total $80 Billion in 2026. gartner.com/en/newsroom.
[11] Bitkom (2026. június 17.): Cloud Report 2026. Reprezentatív felmérés 603 németországi vállalat körében. bitkom.org.
[12] Broadcom (2026): Private Cloud Outlook 2026. Felmérés 1 800 informatikai döntéshozó körében. broadcom.com.
[13] IDC-felmérés 304 döntéshozó körében (2025. december); idézi TechTarget (2026): Enterprises make strides with private AI on-premises.
[14] Epoch AI (2026. május 29.): Open models lag state-of-the-art closed models by 4 months. epoch.ai/data-insights/open-closed-eci-gap.
[15] Yang, X. és mtsai (2024): CRAG — Comprehensive RAG Benchmark. arXiv:2406.04744.
[16] Li, W. és mtsai (2026): Grading Scale Impact on LLM-as-a-Judge: Human-LLM Alignment Is Highest on 0–5 Grading Scale. arXiv:2601.03444.
[17] Miller, E. (2024): Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations. arXiv:2411.00640.
[18] Han, S. és mtsai (2025): Judge’s Verdict: A Comprehensive Analysis of LLM Judge Capability Through Human Agreement. arXiv:2510.09738.
Próbáld ki az AI Act kockázati besorolót
Tudd meg 5 perc alatt, milyen kockázati kategóriába esik az AI rendszered — ingyenes, 100% privát, részletes PDF eredménnyel.